youtube-transcript-api היא ספריית Python חינמית בקוד פתוח שמביאה את הכתוביות של סרטון YouTube: pip install youtube-transcript-api ואז YouTubeTranscriptApi().fetch(video_id). היא עובדת טוב מהמחשב שלכם, אבל משרת ענן YouTube חוסם אותה לעיתים קרובות עם RequestBlocked או IpBlocked, והיא לא עוזרת בסרטונים בלי כתוביות.
הרצנו אותה ממכונה בענן ב-21 בנובמבר 2026, ואז העברנו את אותם שני סרטונים דרך ה-API המתארח שלנו מאותה מכונה. הנה מה שקרה בכל מקרה, איך משתמשים בספרייה ומתי API מתארח מתאים יותר.
מה זה youtube-transcript-api?
ספריית Python של Jonas Depoix, ב-GitHub וב-PyPI, ברישיון MIT. הגרסה הנוכחית היא 1.2.5, ל-Python 3.8 ומעלה.
- היא קוראת את הכתוביות שכבר יש ב-YouTube, של הערוץ עצמו או האוטומטיות של YouTube.
- היא לא צריכה מפתח API ולא דפדפן ללא ממשק.
- היא יכולה להציג את שפות הכתוביות של סרטון, להעדיף שפה אחת על אחרת ולהשתמש בתרגום המכונה של YouTube.
- היא מפיקה טקסט, JSON, SRT או WebVTT, ויש לה כלי שורת פקודה.
ה-README שלה גלוי לגבי הפשרה: היא משתמשת בחלק לא מתועד של נגן הרשת של YouTube, ולכן יש "no guarantee that it won't stop working tomorrow".
איך משתמשים בה?
pip install youtube-transcript-api
from youtube_transcript_api import YouTubeTranscriptApi
from youtube_transcript_api.formatters import SRTFormatter

ytt_api = YouTubeTranscriptApi()

# English if it exists, else German
transcript = ytt_api.fetch("aircAruvnKk", languages=["en", "de"])

for snippet in transcript:
    print(snippet.start, snippet.text)

print(SRTFormatter().format_transcript(transcript))
משורת הפקודה, youtube_transcript_api aircAruvnKk --languages en --format json > transcript.json עושה את אותו הדבר. ה-README מסביר על רשימת שפות, תרגום ועוד.
למה היא נכשלת עם IpBlocked בשרת שלי?
כי YouTube חוסם את רוב הבקשות מספקי ענן. ה-README של הספרייה אומר את זה בבירור: YouTube "has started blocking most IPs that are known to belong to cloud providers (like AWS, Google Cloud Platform, Azure, etc.)", ולכן אחרי פריסת הקוד "most likely" תיתקלו בשגיאות RequestBlocked או IpBlocked. גם כתובת IP ביתית יכולה להיחסם אחרי יותר מדי בקשות.
ראינו את זה בעצמנו. ב-21 בנובמבר 2026 התקנו את גרסה 1.2.5 על מכונה בענן וביקשנו שתי הרצאות פומביות:
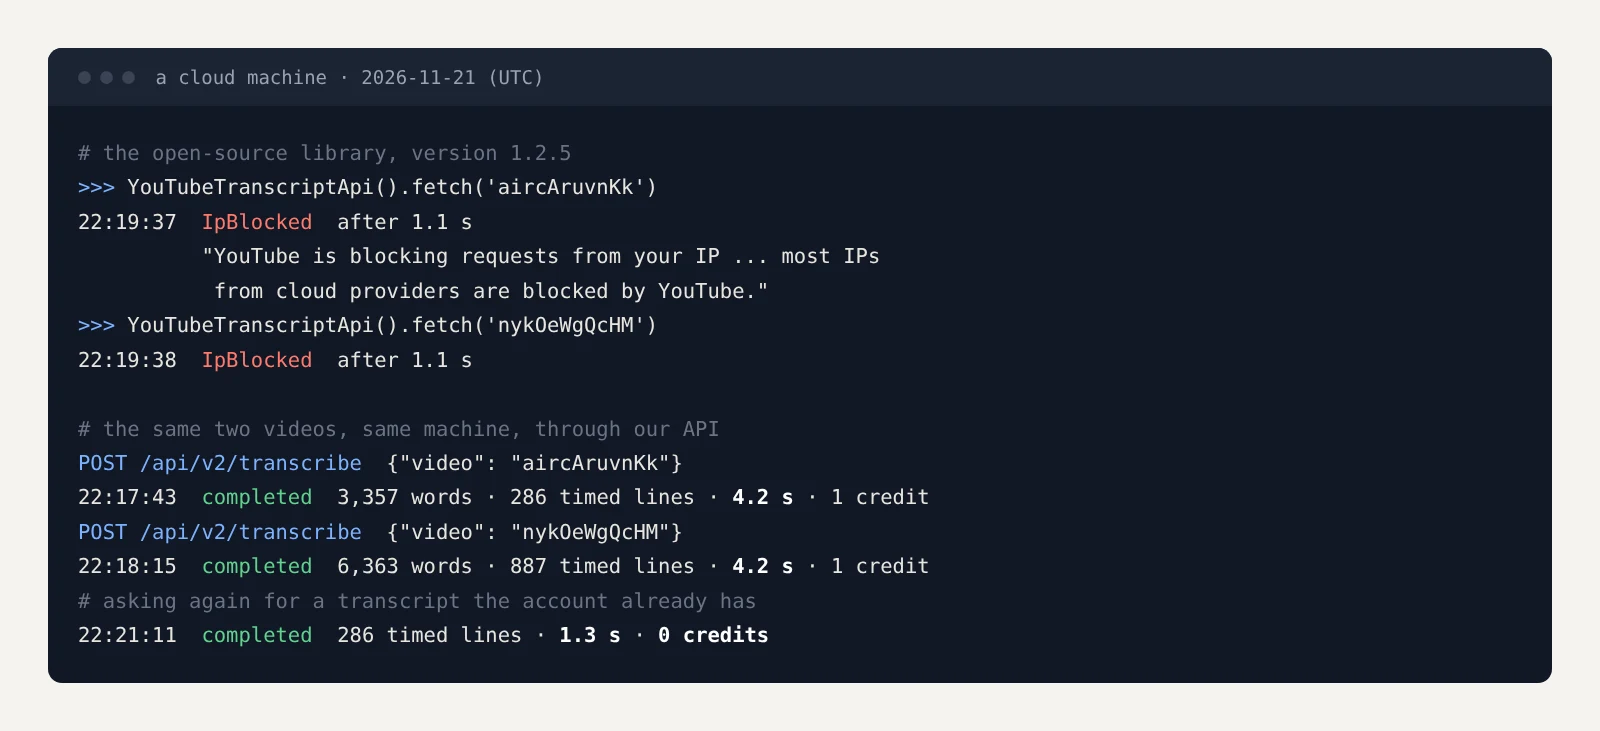 אותה מכונה, אותם שני סרטונים, 21 בנובמבר 2026 (UTC).
שתי הקריאות החזירו IpBlocked אחרי כ-1.1 שניות. בקשה רגילה ל-youtube.com מאותה מכונה הופנתה לעמוד "תנועה חריגה" של Google, כלומר YouTube דחה את המכונה, ולא מדובר בבאג בספרייה.
הפתרון ב-README הוא פרוקסי, והוא ממליץ על פרוקסי ביתיים מתחלפים, כי YouTube חוסם פרוקסי קבועים אחרי שימוש ממושך. זה עובד, אבל זה עוד שירות בתשלום, עוד חשבון וחסימות שצריך לעקוב אחריהן.
מה עוד יכול לעצור אותה?
- אין כתוביות. הספרייה קוראת כתוביות; היא לא מתמללת שמע. כתוביות כבויות מחזירות
TranscriptsDisabled, ושפה חסרה מחזירהNoTranscriptFound. - סרטונים עם הגבלת גיל. לפי ה-README, התחברות באמצעות עוגיות, שהם דורשים, היא "currently not available" אחרי שינויים בצד של YouTube.
- שינויים ב-YouTube. מכיוון שהיא משתמשת בממשק לא מתועד, עדכון של YouTube יכול לשבור אותה עד שתצא גרסה חדשה.
אף אחד מאלה הוא לא סיבה להימנע ממנה בסקריפט על המחשב הנייד. זו סיבה לתכנן מראש לפני שמכניסים אותה למוצר.
במה אפשר להשתמש כשהיא נחסמת?
ב-API תמלילים מתארח, שמבצע את האחזור מהצד שלו. שלנו הוא ה-API של YouTubeTranscript.dev. מאותה מכונה בענן, כמה דקות קודם, אותם שני סרטונים:
| סרטון | אורך | זמן | מילים | שורות עם חותמת זמן | קרדיטים |
|---|---|---|---|---|---|
| But what is a neural network? (3Blue1Brown) | 18:40 | 4.2 שניות | 3,357 | 286 | 1 |
| 1. What is Computation? (MIT OpenCourseWare) | 43:06 | 4.2 שניות | 6,363 | 887 | 1 |
| אותו סרטון של 3Blue1Brown, בבקשה חוזרת | 18:40 | 1.3 שניות | 3,357 | 286 | 0 |
איך מדדנו: בקשה אחת לכל סרטון ל-POST /api/v2/transcribe, כתוביות בלבד עם חותמות זמן, ו-curl מדד את הזמן משליחה ועד תשובה מלאה. הקרדיטים הם מה שכל תשובה דיווחה. הרצה אחת לכל אחד, אז התייחסו לזמנים כדוגמאות.
הקריאה מ-Python:
import requests

r = requests.post(
    "https://www.youtubetranscript.dev/api/v2/transcribe",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"video": "aircAruvnKk", "mode": "auto", "format": {"timestamp": True}},
)
data = r.json()["data"]
for seg in data["transcript"]["segments"]:
    print(seg["start"], seg["text"])  # start and end are in milliseconds
הפשרה היא בעלות: הספרייה חינמית, וה-API עולה קרדיט אחד לכל סרטון עם כתוביות, עם 10 קרדיטים בחינם בחודש ותוכניות בתשלום מ-5 דולר עבור 500. עם "mode": "auto" הוא מתמלל גם סרטונים בלי כתוביות, בקרדיט אחד לכל 2 דקות שמע. יש גם Python SDK אם לא רוצים לכתוב את הבקשה בעצמכם.
איך משלבים API לתמלול במוצר שלי?
אותה תבנית עובדת עם כל API:
- שמרו את המפתח בשרת. המשתמשים שולחים קישור לשרת שלכם, והשרת קורא ל-API. לעולם אל תשימו את המפתח בקוד של הדפדפן או האפליקציה.
- קבלו כל פורמט קישור. העבירו את הקישור כמו שהמשתמש הקליד אותו; שלנו מקבל כתובות מלאות, youtu.be, Shorts, קישורי הטמעה ומזהים בלבד (הרשימה המלאה).
- שמרו את התמליל לפי מזהה סרטון. רוב המוצרים מבקשים שוב ושוב את אותם סרטונים פופולריים. אצלנו, תמליל שכבר יש בחשבון שלכם לא עולה כלום בבקשה חוזרת, כמו שמראה השורה השלישית, אבל עותק מקומי מהיר עוד יותר.
- טפלו בסרטונים בלי כתוביות כמשימה. תמלול שמע לוקח יותר זמן ממה שבקשת רשת צריכה לחכות. שלחו
mode: "auto"עםwebhook_url, או בדקו מדי פעם את מזהה המשימה שחזר, והציגו למשתמש התקדמות. - השתמשו באצוות כשיש הרבה. לפלייליסט, ערוץ או צבר עבודה, השתמשו בנקודת הקצה של האצוות במקום לולאה של קריאות בודדות, כדי להישאר בתוך מגבלת הקצב.
תיעוד ה-API מפרט כל שדה, והמדריך שלנו ל-API דיבור לטקסט מודד דיוק ועלות על שמע בלי כתוביות.
במה כדאי לי להשתמש?
| אם אתם... | השתמשו ב |
|---|---|
| מריצים סקריפט על המחשב שלכם, כמה סרטונים בכל פעם | youtube-transcript-api |
| פורסים לשרת ענן, לפונקציה ללא שרת או למוצר | API מתארח, או הספרייה עם פרוקסי ביתיים מתחלפים |
| מטפלים בסרטונים בלי כתוביות | שירות שמתמלל שמע |
| מושכים פלייליסטים או ערוצים שלמים | API מתארח עם נקודת קצה לאצוות |
לסיכום
- youtube-transcript-api חינמית, ברישיון MIT ופשוטה:
YouTubeTranscriptApi().fetch(video_id). - בשרת ענן YouTube חוסם אותה לעיתים קרובות; במכונה שלנו בענן שני הסרטונים החזירו
IpBlockedאחרי כ-1.1 שניות. הפתרון המוצע הוא פרוקסי. - היא קוראת רק כתוביות קיימות, וסרטונים עם הגבלת גיל לא עובדים כרגע.
- API מתארח החזיר את אותם סרטונים מאותה מכונה ב-4.2 שניות כל אחד, בקרדיט אחד כל אחד, ומטפל גם בסרטונים בלי כתוביות.
שאלות נפוצות
מה זה youtube-transcript-api?+
ספריית Python בקוד פתוח (רישיון MIT) שמביאה את הכתוביות שכבר קיימות לסרטון ב-YouTube, כולל אוטומטיות, בלי מפתח API ובלי דפדפן. מתקינים עם pip install youtube-transcript-api וקוראים ל-YouTubeTranscriptApi().fetch(video_id).
למה youtube-transcript-api מחזירה RequestBlocked או IpBlocked?+
כי YouTube חוסם את רוב הבקשות מכתובות IP של ספקי ענן, ויכול לחסום כל כתובת ששולחת יותר מדי בקשות. ה-README של הספרייה אומר את זה בעצמו וממליץ על פרוקסי ביתיים מתחלפים. מהמכונה שלנו בענן, ב-21 בנובמבר 2026, שני הסרטונים שבדקנו החזירו IpBlocked אחרי כ-1.1 שניות.
האם youtube-transcript-api יכולה לתמלל סרטון בלי כתוביות?+
לא. היא קוראת כתוביות קיימות. סרטון שהכתוביות בו כבויות מחזיר TranscriptsDisabled, וסרטון בלי השפה שלכם מחזיר NoTranscriptFound. כדי להפיק טקסט מהשמע צריך שירות דיבור לטקסט.
האם youtube-transcript-api חינמית?+
כן, הספרייה חינמית ברישיון MIT. הרצה בשרת בדרך כלל דורשת לשלם על פרוקסי, כי כתובות IP של ענן חסומות.
במה אפשר להשתמש בשרת במקום youtube-transcript-api?+
ב-API תמלילים מתארח שמבצע את האחזור בשבילכם. מאותה מכונה שבה הספרייה נחסמה, ה-API של YouTubeTranscript.dev החזיר את שני הסרטונים ב-4.2 שניות כל אחד, בקרדיט אחד כל אחד, ובקשה חוזרת ב-1.3 שניות בחינם.
איך משלבים API לתמלול במוצר שלי?+
שמרו את מפתח ה-API בשרת, שלחו את קישור הסרטון לנקודת קצה אחת, שמרו את התמליל לפי מזהה הסרטון כדי לא לשלם פעמיים, טפלו בסרטונים בלי כתוביות כמשימה אסינכרונית עם Webhook, והשתמשו בנקודת קצה של אצוות לסרטונים רבים.