youtube-transcript-apiは、YouTube動画の字幕を取得する無料のオープンソースのPythonライブラリです。pip install youtube-transcript-apiのあとYouTubeTranscriptApi().fetch(video_id)を呼ぶだけです。自分のパソコンからはよく動きますが、クラウドサーバーからはYouTubeにRequestBlockedやIpBlockedでブロックされることが多く、字幕のない動画には使えません。
2026年11月21日にクラウドマシンで実行し、続いて同じマシンから同じ2本の動画を私たちのホスト型APIに通しました。それぞれの結果、ライブラリの使い方、ホスト型APIが向いている場面をまとめます。
youtube-transcript-apiとは?
Jonas Depoix氏によるPythonライブラリで、GitHubとPyPIで公開されており、MITライセンスです。執筆時点の最新版は1.2.5で、Python 3.8以上に対応しています。
- YouTubeにすでにある字幕(チャンネル自身の字幕やYouTubeの自動字幕)を読みます。
- APIキーもヘッドレスブラウザも不要です。
- 動画の字幕の言語一覧の取得、言語の優先指定、YouTubeの機械翻訳の利用ができます。
- テキスト、JSON、SRT、WebVTTで出力でき、コマンドラインツールもあります。
READMEはトレードオフを率直に書いています。YouTubeのWebプレーヤーの非公開部分を使っているため、「no guarantee that it won't stop working tomorrow」とのことです。
使い方は?
pip install youtube-transcript-api
from youtube_transcript_api import YouTubeTranscriptApi
from youtube_transcript_api.formatters import SRTFormatter

ytt_api = YouTubeTranscriptApi()

# English if it exists, else German
transcript = ytt_api.fetch("aircAruvnKk", languages=["en", "de"])

for snippet in transcript:
    print(snippet.start, snippet.text)

print(SRTFormatter().format_transcript(transcript))コマンドラインではyoutube_transcript_api aircAruvnKk --languages en --format json > transcript.jsonで同じことができます。言語一覧や翻訳などはREADMEに載っています。
サーバーでIpBlockedになるのはなぜ?
YouTubeがクラウド事業者からのリクエストの大半をブロックしているからです。ライブラリのREADMEにははっきりこう書かれています。YouTubeは「has started blocking most IPs that are known to belong to cloud providers (like AWS, Google Cloud Platform, Azure, etc.)」ので、コードをデプロイすると「most likely」RequestBlockedやIpBlockedのエラーになる、と。自宅のIPでも、リクエストが多すぎればブロックされることがあります。
私たちも実際に確認しました。2026年11月21日、クラウドマシンにバージョン1.2.5を入れ、公開講義2本を取得しようとしました。
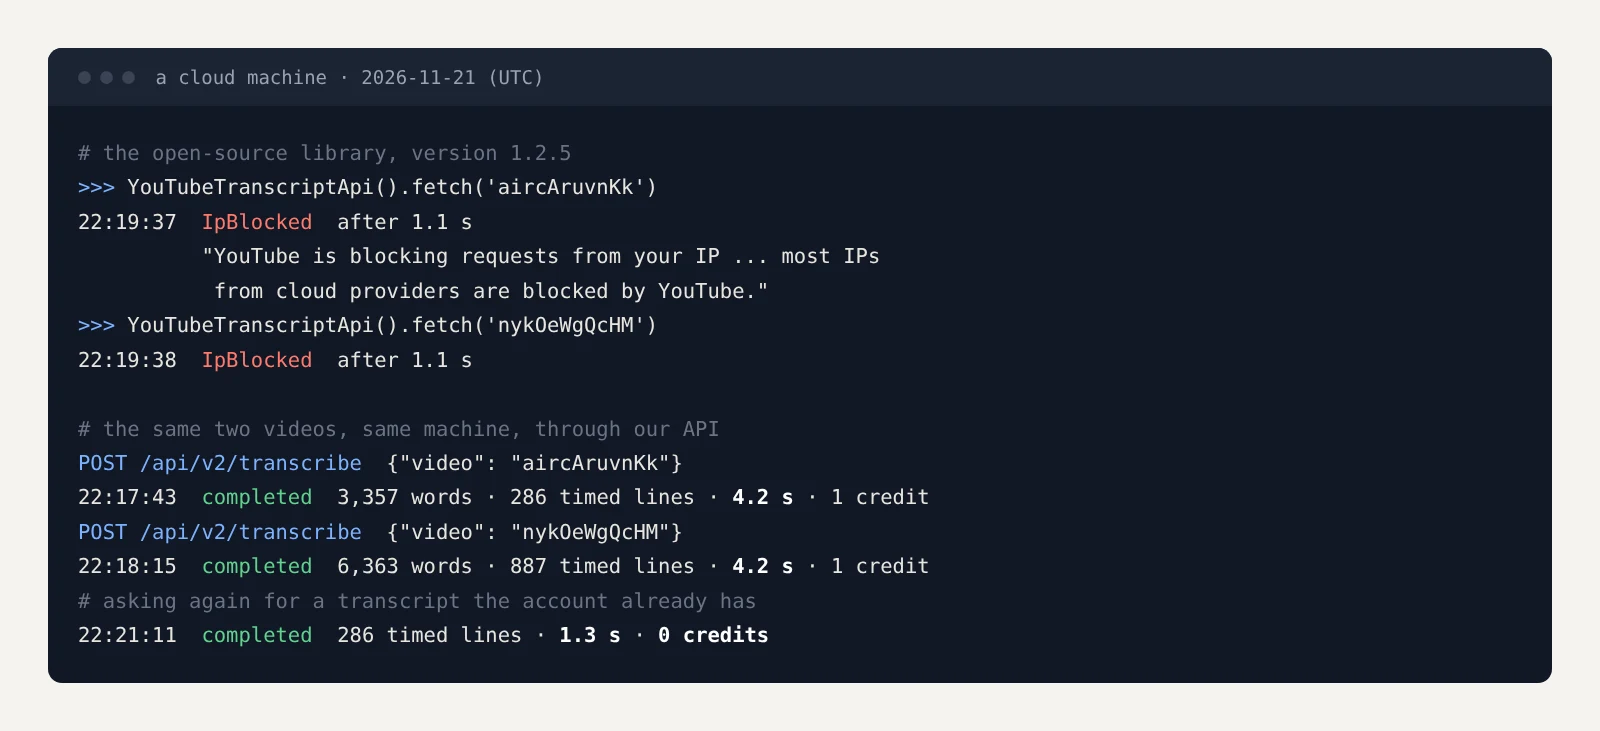 同じマシン、同じ2本の動画、2026年11月21日(UTC)。
2回とも約1.1秒でIpBlockedになりました。同じマシンからyoutube.comに普通にアクセスすると、Googleの「異常なトラフィック」のページにリダイレクトされました。つまりライブラリの不具合ではなく、YouTubeがマシンを拒否していたのです。
READMEの解決策はプロキシで、YouTubeは固定のプロキシを長く使うとブロックするため、ローテーションする住宅用プロキシを勧めています。これで動きますが、有料サービスとアカウントが1つ増え、ブロックの監視も必要になります。
ほかに止まる原因は?
- 字幕がない。 ライブラリは字幕を読むもので、音声を文字起こしはしません。字幕が無効なら
TranscriptsDisabled、言語がなければNoTranscriptFoundになります。 - 年齢制限のある動画。 READMEによれば、これらに必要なCookieでのログインは、YouTube側の変更により「currently not available」です。
- YouTubeの変更。 非公開のインターフェースを使っているため、YouTubeの更新で新しいバージョンが出るまで動かなくなることがあります。
どれも、ノートパソコンでスクリプトを動かす分には避ける理由になりません。プロダクトに組み込む前に計画しておくべき理由です。
ブロックされたら代わりに何を使う?
取得を自分の側で行うホスト型の文字起こしAPIです。私たちのものはYouTubeTranscript.devのAPIです。同じクラウドマシンから、その数分前に同じ2本を取得した結果です。
| 動画 | 長さ | 時間 | 語数 | タイムスタンプ付きの行 | クレジット |
|---|---|---|---|---|---|
| But what is a neural network? (3Blue1Brown) | 18:40 | 4.2秒 | 3,357 | 286 | 1 |
| 1. What is Computation? (MIT OpenCourseWare) | 43:06 | 4.2秒 | 6,363 | 887 | 1 |
| 同じ3Blue1Brownの動画を再リクエスト | 18:40 | 1.3秒 | 3,357 | 286 | 0 |
測定方法: それぞれPOST /api/v2/transcribeに1回、字幕のみ・タイムスタンプありでリクエストし、curlで送信から完全な応答までを計測しました。クレジットは各応答が報告した値です。各1回の計測なので、時間は一例です。
Pythonからの呼び出し:
import requests

r = requests.post(
    "https://www.youtubetranscript.dev/api/v2/transcribe",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"video": "aircAruvnKk", "mode": "auto", "format": {"timestamp": True}},
)
data = r.json()["data"]
for seg in data["transcript"]["segments"]:
print(seg["start"], seg["text"]) # start and end are in millisecondsトレードオフは費用です。ライブラリは無料、APIは字幕付きの動画1本につき1クレジットで、毎月10クレジット無料、有料プランは500クレジットで5ドルからです。"mode": "auto"にすれば字幕のない動画も、音声2分ごとに1クレジットで文字起こしします。リクエストを自分で書きたくなければPython SDKもあります。
文字起こしAPIを自社プロダクトに組み込むには?
どのAPIでも同じ手順が使えます。
- キーはサーバーに置く。 ユーザーはリンクをバックエンドに送り、バックエンドがAPIを呼びます。ブラウザやアプリのコードにキーを入れてはいけません。
- どんなリンク形式も受け付ける。 ユーザーが入力したままのリンクを渡します。私たちのAPIは完全なURL、youtu.be、ショート、埋め込みリンク、IDのみを受け付けます(全リスト)。
- 動画IDごとに文字起こしを保存する。 ほとんどのプロダクトでは同じ人気動画が何度もリクエストされます。私たちのAPIでは、アカウントがすでに持っている文字起こしの再取得は表の3行目のとおり無料ですが、ローカルのコピーならさらに速くなります。
- 字幕のない動画はジョブとして扱う。 音声の文字起こしは、Webリクエストで待つべき時間より長くかかります。
mode: "auto"とwebhook_urlを送るか、返ってきたジョブIDをポーリングし、ユーザーには進行状況を表示します。 - 数が多いならバッチを使う。 再生リスト、チャンネル、たまった作業には、単発の呼び出しをループする代わりにバッチ用エンドポイントを使い、レート制限内に収めます。
各フィールドはAPIドキュメントに、字幕のない音声での精度と費用の計測は音声認識APIガイドにあります。
どちらを使うべき?
| こんなとき | 使うもの |
|---|---|
| 自分のパソコンでスクリプトを動かし、数本ずつ処理する | youtube-transcript-api |
| クラウドサーバー、サーバーレス関数、プロダクトにデプロイする | ホスト型API、またはライブラリとローテーションする住宅用プロキシ |
| 字幕のない動画を扱う | 音声を文字起こしするサービス |
| 再生リストやチャンネルを丸ごと取得する | バッチ用エンドポイントのあるホスト型API |
まとめ
- youtube-transcript-apiは無料、MITライセンスで簡単です:
YouTubeTranscriptApi().fetch(video_id)。 - クラウドサーバーではYouTubeにブロックされることが多く、私たちのクラウドマシンでは2本とも約1.1秒で
IpBlockedになりました。推奨される回避策はプロキシです。 - 既存の字幕しか読めず、年齢制限のある動画は現在使えません。
- ホスト型APIは同じマシンから同じ動画をそれぞれ4.2秒・1クレジットで返し、字幕のない動画にも対応します。
よくある質問
youtube-transcript-apiとは?+
YouTubeにすでにある動画の字幕(自動字幕を含む)を、APIキーもブラウザも使わずに取得するオープンソースのPythonライブラリ(MITライセンス)です。pip install youtube-transcript-apiでインストールし、YouTubeTranscriptApi().fetch(video_id)で呼び出します。
youtube-transcript-apiでRequestBlockedやIpBlockedが出るのはなぜ?+
YouTubeがクラウド事業者のIPアドレスからのリクエストの大半をブロックし、リクエストが多すぎるIPも遮断することがあるためです。ライブラリのREADME自体がそう書いており、ローテーションする住宅用プロキシを勧めています。2026年11月21日、私たちのクラウドマシンでは試した2本とも約1.1秒でIpBlockedになりました。
youtube-transcript-apiは字幕のない動画を文字起こしできますか?+
いいえ。既存の字幕を読むだけです。字幕が無効な動画ではTranscriptsDisabled、希望の言語がない動画ではNoTranscriptFoundになります。音声からテキストを得るには音声認識サービスが必要です。
youtube-transcript-apiは無料ですか?+
はい、ライブラリは無料でMITライセンスです。ただしクラウドのIPはブロックされるため、サーバーで使うには通常プロキシの費用がかかります。
サーバーでyoutube-transcript-apiの代わりに何を使えますか?+
取得を代わりに行うホスト型の文字起こしAPIです。ライブラリがブロックされたのと同じマシンから、YouTubeTranscript.devのAPIは2本の動画をそれぞれ4.2秒・1クレジットで返し、再リクエストは1.3秒・無料でした。
文字起こしAPIを自社プロダクトに組み込むには?+
APIキーはサーバーに置き、動画リンクを1つのエンドポイントに送り、二重に支払わないよう動画IDごとに文字起こしを保存し、字幕のない動画はWebhook付きの非同期ジョブとして扱い、多数の動画にはバッチ用エンドポイントを使います。